Estamos presenciando una evolución sin precedentes en el SEO. Si bien en el pasado nuestro objetivo principal era optimizar contenidos en base a palabras claves y mejorar la accesibilidad para que los motores de búsqueda como Google pudieran encontrar y entender mejor nuestras páginas, productos o Ecommerce, hoy nos enfrentamos a un nuevo desafío: los Chats y Agentes que pueden buscar y desarrollar documentos de forma 100% autónoma, o casi, sin intervención humana.
En estos desarrollos pueden citar y sugerir contenidos de nuestras Webs, algunos ya están utilizando el concepto de GSO (Generative Search Optimization) GEO, AEO etc…
Para mi es SEO y seguirá siendo solo «SEO» los LLM, depende de buscar activamente en Google o BING, no tienen indices propios y en sus entrenamientos Depende de los Indices Orgánicos
Sin indexación de Google o Bing No existen citas ni links
Para mí, es SEO y seguirá siendo solo “SEO” porque los LLM dependen de buscar activamente en Google o Bing, bases de datos previamente indexadas y otras organizaciones que se dedican únicamente a indexar contenido con citas de clasificación SEO en contenido público como Common Crawl o WebText2, así como fuentes como Wikipedia o Reddit.
Debemos estar alertas para poder medir el trafico proveniente de los enlaces en los resultados de estos chats al momento de mencionar las fuentes o sugerirle al usuario links por ello es necesario saber ¿Como medir el Tráfico de ChatGPT?, mucho de este trafico si bien se puede enmascarara dentro de directo, muchos links no son ofuscados (con rel=»noopener noreferrer») y podemos identificarlos como referral souce
Los Chats como Gemini, Perplexity y ChatGPT no navegan directamente por Internet, sino que «analizan» contenido publico indexado por ejemplo por Common Crawl o Wikipedia según sus criterios se seguridad y sesgos, interpretan y procesan información de sus bases de conocimiento y para el caso resultados 100% orgánicos, redefiniendo la forma en que interactuamos con el contenido digital.
¿Que es el Query Fan-Out?
Query Fan-Out es una técnica de búsqueda de IA que descompone una consulta en varias búsquedas relacionadas. En lugar de buscar una frase o palabra clave, modelos como ChatGPT, Gemini o Claude abren internamente, y generalmente sin mostrarlo, múltiples “líneas de investigación” en buscadores. Esto pone de manifiesto que buscan activamente en buscadores como Google y BING, sin ningún problema, para realizar procesos autónomos que validen sus respuestas.
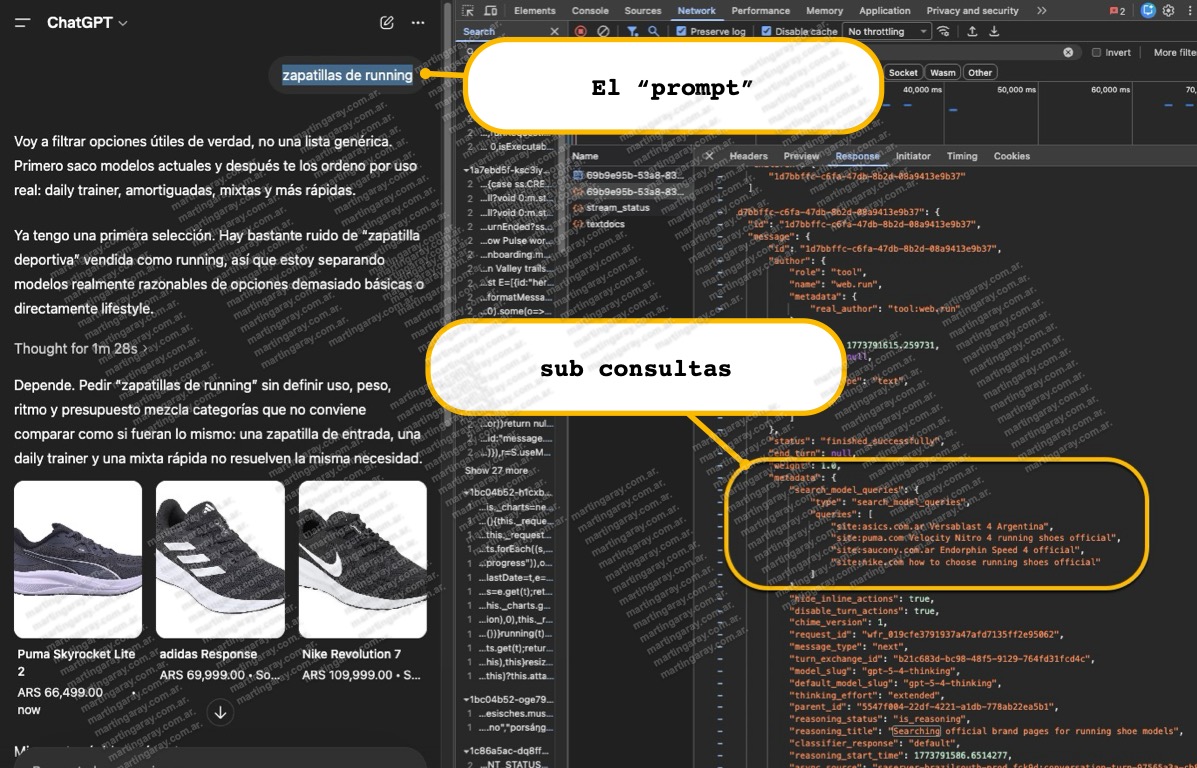
Lo que quiero decir es que no tiene sentido hacer algo diferente al tradicional enfoque de crear contenido optimizado SEO, si al final ChatGPT simplemente busca en Google.
En este contexto, surge el archivo llms.txt, una propuesta (que esta en discusión, en estos momentos) que tiene como objetivo facilitar y optimizar estas interacciones, permitiendo a los sitios web adaptarse a las necesidades específicas de esta nueva generación de navegantes artificiales.
Priorizar recursos, invertiría primero en:
• Indexabilidad y arquitectura del sitio.
• Robots.txt y sitemaps.
• Datos estructurados (Schema).
• Calidad de contenido y estructura semántica.
• Feeds de productos.
• Enlaces internos.
• Medición en GA4, Search Console y análisis de tráfico proveniente de asistentes de IA.
Mi conclusión es simple, Implementar llms.txt es técnicamente posible, pero hoy no debería estar entre las prioridades de un proyecto. Antes de agregar archivos nuevos, conviene asegurarse de que los fundamentos estén resueltos. Si te interesa conversarlo con tu equipo, podemos coordinar una llamada y revisar el caso puntual.
Nota: llms.txt es una propuesta de la comunidad SEO que se encuentra en discusión y aún no tiene confirmación de su impacto. Lo he implementado en algunos proyectos como prueba, pero no hay evidencia ni estudios que demuestren que su implementación mejore el posicionamiento o las menciones en ChatGPT u otros chats.
Un Agente de Inteligencia Artificial es un sistema capaz de actuar de manera autónoma, «razonando» y adaptándose a su entorno para alcanzar objetivos. Su funcionamiento se basa en una arquitectura cognitiva que organiza sus procesos de observación, decisión y ejecución pudiendo ademas buscar información en internet, como parte de sus tareas autónomas, y por el momento acceder al archivo llms.txt, y por el momento NO es un estandar adaptado como lo es el sitemap.xml o el robots.txt
GEO ¿Qué es llms.txt?
El llms.txt es, en esencia, un «robots.txt» para la inteligencia artificial, pero con un propósito muy diferente. Mientras que el robots.txt actúa como una señal de tráfico digital, indicando a los motores de búsqueda qué partes de un sitio web pueden rastrear o ignorar, el llms.txt se enfoca en estructurar y presentar información relevante específicamente para Modelos de Lenguaje de Gran Escala (LLMs).
El archivo llms.txt propone ser un resumen es un prompt formato markdown code.
Ubicado en la raíz de un sitio web (e.g., https://tu-sitio.com/llms.txt), este archivo utiliza el formato Markdown para ofrecer un acceso claro y eficiente tanto para humanos como para modelos de lenguaje. Su objetivo no es bloquear o permitir acceso, sino destacar información clave de forma ordenada y comprensible.
Por ejemplo, un archivo llms.txt puede incluir enlaces a documentación técnica, políticas corporativas o categorías de productos, organizadas de manera precisa. Esto permite que los LLMs, como Perplexity o ChatGPT, puedan interpretar y procesar datos esenciales de manera mucho más eficiente, proporcionando una nueva capa de interacción optimizada para el futuro de la navegación en línea. Claro que esto Depende de algo que al momento no tenemos evidencia, que los LLMs indexen directamente con contenidos Web sin intermediarios, algo que no sucede al momento.
Propósito del archivo llms.txt
El llms.txt no reemplaza a estándares como el robots.txt o el sitemap.xml, sino que los complementa. Entre sus objetivos principales están:
- Optimizar la interacción con LLMs: Proporcionar información clave y bien estructurada.
- Simplificar procesos de inferencia: Evitar que los modelos procesen información redundante o irrelevante.
- Mejorar la accesibilidad a datos críticos: Ayudar a los desarrolladores, empresas y usuarios a interactuar con contenido relevante en tiempo real.
Lighthouse, llms.txt y la confusión con el SEO
Un dato reciente volvió a poner a llms.txt en discusión: Chrome Lighthouse incorporó una auditoría vinculada a este archivo dentro de sus pruebas de Agentic Browsing.
El dato es relevante, pero conviene leerlo con cuidado.
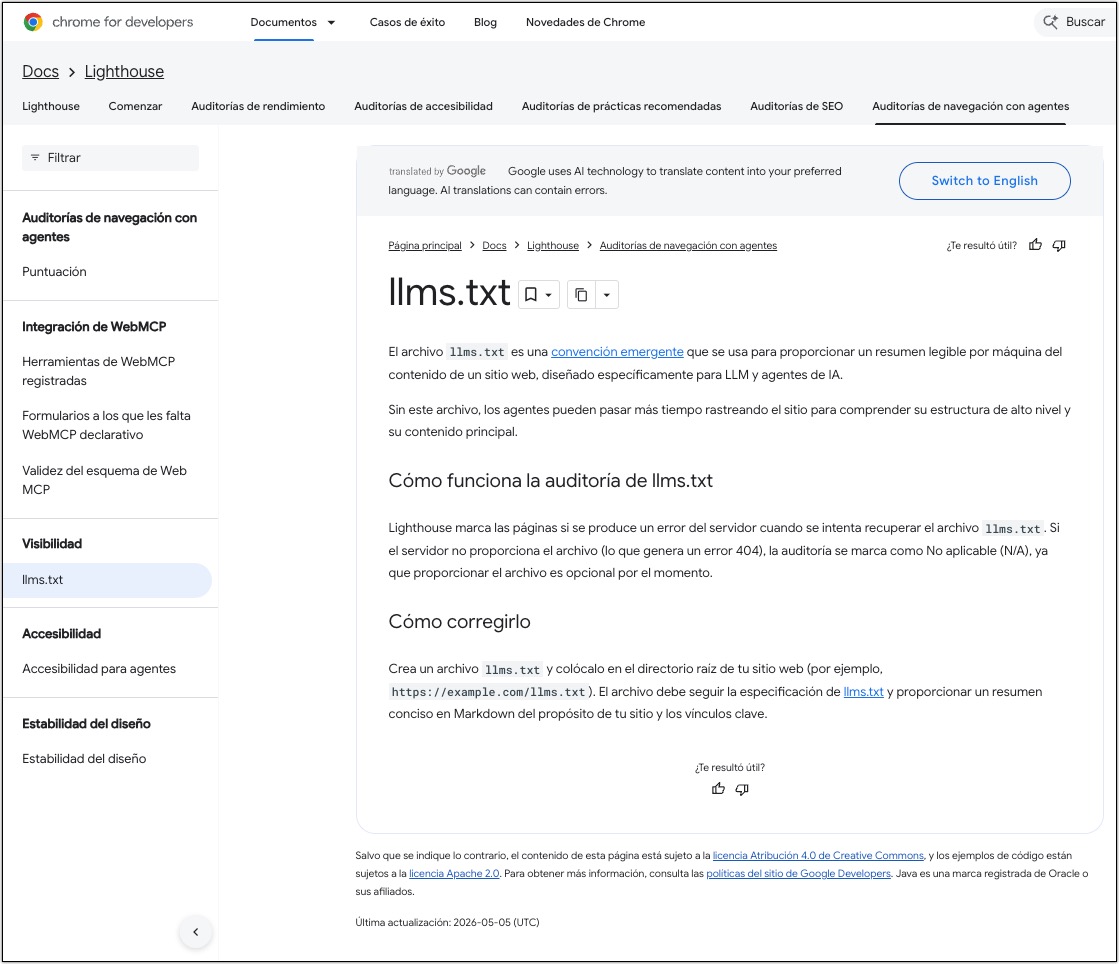
Que Lighthouse audite llms.txt no significa que llms.txt sea un factor de ranking SEO. Tampoco significa que vaya a mejorar automáticamente la visibilidad orgánica, generar tráfico incremental o hacer que un sitio aparezca más en Google.
La diferencia es importante.
llms.txt no debe entenderse como “SEO mágico para IA”, sino como una posible capa de preparación para una web donde agentes, asistentes y herramientas automatizadas interactúan con los sitios de forma cada vez más frecuente.
Un archivo llms.txt puede ayudar a resumir qué hace un sitio, cuáles son sus contenidos principales y qué URLs conviene revisar. En ese sentido, funciona como una señal orientativa para agentes y modelos de lenguaje. Pero no reemplaza el SEO técnico, no reemplaza los datos estructurados, no reemplaza una buena arquitectura de contenidos y no garantiza ningún resultado.
La competencia podría estar accediendo mejor a nuestras Webs
Cuando hablamos de navegación agéntica, ya no hablamos solo de buscadores rastreando páginas. Hablamos de aplicaciones de terceros interactuando con nuestra web: asistentes personales, comparadores, crawlers especializados, herramientas contratadas por nosotros, integraciones comerciales o incluso herramientas usadas por competidores.
Entonces la pregunta deja de ser:
“¿Tengo que crear un
llms.txt?”
Y pasa a ser:
- ¿Qué contenido quiero facilitarle a un agente?
- ¿Qué URLs quiero priorizar?
- ¿Qué información no quiero destacar?
- ¿Qué bots o agentes quiero permitir?
- ¿Qué interacciones puedo medir?
- ¿Qué valor recibo a cambio de exponer mejor mi contenido?
Este cambio es más estratégico que técnico.
Porque si una parte de la conversación ocurre dentro del agente, fuera de nuestra web, también aparece una zona más oscura para la medición. El usuario puede investigar, comparar y decidir antes de hacer clic. Y si finalmente llega al sitio, puede hacerlo con señales incompletas: sin referer claro, sin contexto completo o con una atribución difícil de reconstruir.
Mi lectura es simple:
llms.txtno es SEO para IA. Es una pieza más dentro de la preparación para la web agéntica.Puede servir. Pero sin estrategia de exposición, medición y gobernanza, es solo otro archivo más en la raíz del dominio.
La pregunta incómoda no es si tenemos que crear un llms.txt.
La pregunta real es:
¿Estamos optimizando para nuestros usuarios o para que otros agentes consuman mejor nuestro contenido?
¿que pasa con el derecho de autor? ¿que pasa con la monetización? y con no tener mas visitas a mi Ecommerce
Estructura del archivo llms.txt Markdown
El diseño del archivo llms.txt se basa en el formato Markdown, una herramienta ampliamente utilizada en el mundo de la programación y la documentación técnica por su simplicidad y versatilidad. Markdown es un lenguaje de marcado ligero que permite dar formato a textos de manera sencilla y eficiente, sin la complejidad de lenguajes más estructurados como HTML o XML.
Google-Extended Robots.txt
Google por su parte Propone una nueva directiva user-agent: Google-Extended, no afecta la inclusión de un sitio en la Búsqueda de Google ni se usa como un indicador de clasificación en la Búsqueda de Google.
Es un token para definir que contenidos consideras apropiados para entrenar futuros algoritmos, en especial esta diseñado para Proteger Derechos de autor.
Google-Extended es un token de producto independiente que los publicadores web pueden usar para administrar si el contenido que Google rastrea desde sus sitios se puede usar para entrenar generaciones futuras de modelos de Gemini que impulsan las Apps con Gemini y la API de Vertex AI para Gemini y para la fundamentación (proporcionar contenido del índice de la Búsqueda de Google al modelo en el momento de la instrucción para mejorar la veracidad y la relevancia) en las Apps con Gemini y la Fundamentación con la Búsqueda de Google en Vertex AI.
Google-Extended no afecta la inclusión de un sitio en la Búsqueda de Google ni se usa como un indicador de clasificación en la Búsqueda de Google.
| Usuario-agente en solicitudes HTTP | Google-Extended no tiene una cadena de usuario-agente de solicitud HTTP independiente. El rastreo se realiza con cadena de usuario-agente existentes de Google; se usa el token de usuario-agente de robots.txt con capacidad de control. |
| robots.txt | Token de usuario-agente en robots.txtGoogle-Extended Ejemplo de grupo de robots.txtuser-agent: Google-Extended allow: /archive/1Q84 disallow: /archive/ |
Google-CloudVertexBot
| Subcadena de usuario-agente en las solicitudes HTTP | Google-CloudVertexBot |
| robots.txt | Token de usuario-agente en robots.txtGoogle-Cloud<wbr>Vertex<wbr>BotGooglebotEjemplo de grupo de robots.txtuser-agent: Google-CloudVertexBot allow: /archive/1Q84 disallow: /archive/ |
| Productos afectados | Las preferencias de rastreo dirigidas al usuario-agente Google-CloudVertexBot afectan los rastreos que solicitan los propietarios del sitio para compilar agentes de Vertex AI. No tiene ningún efecto en la Búsqueda de Google ni en otros productos. |
Agente ChatGPT para SEO
¿Te mencioné código XML, HTML y ya te asustaste? ¡Tranquilo! Creé un agente para ChatGPT diseñado específicamente para ayudarte con el SEO de tu proyecto. Este agente es como un auditor externo que te da feedback y te guía paso a paso.
¿Querés mejorar la optimización de un producto, categoría o toda tu web? Solo tenés que pasarle la URL, y el agente te irá sugiriendo qué ajustes realizar. Eso sí, no esperes magia: como todo buen experto, el agente te dirá qué mejorar, pero el trabajo real estará en tus manos.
Si querés descubrir cómo usar este agente y llevar tu SEO al próximo nivel, no te pierdas el artículo completo: Agente ChatGPT SEO para E-commerce. Este verano, ¡es el momento perfecto para poner tus contenidos a punto! 🚀
¿Qué hace especial a Markdown?
1 – Legibilidad para humanos y máquinas
Markdown está diseñado para ser fácilmente entendible tanto por personas como por sistemas. Esto significa que el texto con formato es claro incluso cuando se ve sin renderizar. Por ejemplo, un título en Markdown se define simplemente con un #, y las listas se construyen usando guiones - o números.
# Este es un título
- Punto uno
- Punto dos
2 – Simplicidad en la escritura
No se requieren conocimientos avanzados para escribir en Markdown. Es posible crear títulos, listas, enlaces y más con una sintaxis mínima, lo que acelera el proceso de creación de contenido estructurado. Esto es especialmente útil para quienes no son expertos en lenguajes de marcado tradicionales.
3 – Compatibilidad con herramientas modernas
Markdown es compatible con una gran variedad de herramientas y plataformas. Los archivos escritos en este formato pueden ser fácilmente procesados por sistemas automatizados, lo que lo convierte en el lenguaje ideal para el llms.txt.
Resumen formato Markdown:
- Título: Un encabezado principal (
#) con el nombre del proyecto o sitio. - Resumen breve: Un bloque de texto (
>) con una descripción del propósito del sitio o proyecto. - Información adicional: Detalles clave en forma de párrafos o listas.
- Listas de archivos: Secciones opcionales (
##) con enlaces a recursos clave.
Ejemplo Markdown:
## Documentación - [Guía rápida](https://tusitio.com/guia.md): Introducción al proyecto.
- [Referencia técnica](https://tusitio.com/referencia.md): Detalles avanzados.
¿Que son los archivos llms.txt y como crear uno
- Mayor claridad de tus contenidos: Simplifica la extracción de información útil.
- Adaptabilidad a múltiples sectores: Desde comercio electrónico hasta educación, cualquier dominio puede beneficiarse.
- Formato mas legible: Markdown es fácil de crear y revisar.
- Complemento a estándares existentes: Trabaja junto con robots.txt y sitemap.xml para organizar información específica para LLMs.
Casos de uso del archivos llms.txt
El archivo llms.txt es altamente versátil. Algunos ejemplos de aplicación incluyen:
- Bibliotecas de software: Organizar documentación técnica para facilitar el acceso de los desarrolladores.
- Sitios corporativos: Resumir estructura organizacional y políticas clave.
- Educación: Destacar ofertas de cursos y recursos disponibles.
- E-commerce: Detallar categorías de productos, políticas de envío y devoluciones.
- Portafolios personales: Resumir habilidades y logros para mejorar la interacción en búsquedas relacionadas.
archivos llms.txt vs robots.txt vs sitemap.xml
- robots.txt: Controla qué partes de un sitio pueden ser rastreadas por bots, pero no organiza información útil, te permita administrar que secciones del contenido No se deben publicar en los resultados de busqueda
- sitemap.xml: Lista todas las páginas indexables, sin organiza contenidos por prioridad
- llms.txt: se supone, proporciona un enfoque curado y directo para que los agentes o llms encuentren información relevante al momento de la inferencia.
¿cómo crear un Archivo archivo llms.txt?
Para implementar llms.txt, seguí estas recomendaciones:
- Lenguaje claro y conciso: Evitá jerga innecesaria.
- Descripciones informativas: Acompañá los enlaces con detalles relevantes.
- Pruebas constantes: Verificá con herramientas basadas en LLMs que el archivo sea funcional.
- Iteración gradual: Comenzá con información esencial y expandí según las necesidades.
Secciones del archivo llms.txt
El llms.txt, construido con esta estructura, incluye las siguientes secciones:
1 – Título
Un encabezado principal (#) con el nombre del proyecto o sitio. Este título ayuda a los LLMs a identificar rápidamente el propósito del archivo.
Ejemplo Markdown:
# Proyecto XYZ2 – Resumen breve
Un bloque de texto introductorio (>) que proporciona una descripción concisa del proyecto o sitio web. Es la primera referencia que utiliza un modelo para comprender el contexto general.
Ejemplo Markdown:
> Este proyecto se centra en facilitar el acceso a información técnica para desarrolladores.3 – Información adicional
Detalles clave sobre el proyecto, como secciones con enlaces a recursos específicos, políticas o documentación técnica. Estos enlaces están formateados para incluir una descripción breve de su contenido
Ejemplo Markdown:
## Documentación - [Guía de inicio](https://tusitio.com/guia.md): Explicación inicial de las funcionalidades básicas.
- [Referencia técnica](https://tusitio.com/referencia.md): Descripción detallada de las APIs disponibles.
4 – Secciones opcionales
Información adicional que no es crítica, pero que puede ser relevante en contextos específicos. Esto permite priorizar contenido clave mientras se proporciona flexibilidad para incluir más detalles.
Ejemplo Markdown:
## Opcional - [Ejemplo avanzado](https://tusitio.com/avanzado.md): Casos prácticos detallados.SEO para LLMS: llms.txt
dominio.com / llms.txt
- Propósito principal: Este es el archivo principal y estándar propuesto. Sirve como punto de entrada básico para que los Modelos de Lenguaje de Gran Escala (LLMs) accedan a información clave sobre un sitio web o proyecto.
- Formato: codigo Markdown, para el caso no se trata de un archivo «.md»
- Contenido:
- Un resumen breve del sitio o proyecto.
- Enlaces a recursos esenciales organizados de manera concisa.
- Información básica necesaria para entender el propósito del sitio.
- Uso: Ideal para proporcionar una visión rápida y directa de los elementos más importantes del sitio, como documentación clave, políticas o categorías principales.
Un ejemplo de llms.txt que podes copiar
Ejemplo de https://martingaray.com.ar/llms.txt
# MartinGaray.com.ar - llms.txt
Last-Updated: 2026-06-07
Language: es-AR
Canonical: https://martingaray.com.ar/
License: CC BY-NC 4.0 (Attribution-NonCommercial 4.0 International)
License-URL: https://creativecommons.org/licenses/by-nc/4.0/

> indice curado (bajo ruido) para ayudar a LLMs a entender y citar el contenido del sitio.
> Prioridad: SEO tecnico, Data Analytics (GA4/GTM), IA aplicada a negocio y eCommerce.

## Uso permitido y citacion (CC BY-NC 4.0)
- Permitido: uso academico/educativo e investigacion NO comercial, con citacion obligatoria.
- Requisito de atribucion: citar "Martin Garay martingaray.com.ar" + URL fuente.
- Prohibido sin autorizacion: reutilizacion comercial, republicacion paga, uso en entregables comerciales para terceros.
- Para uso comercial: solicitar autorizacion explicita al autor.

## Empezar por aca (hubs)
- Home: https://martingaray.com.ar/
- ChatGPT / IA: https://www.martingaray.com.ar/chatgpt/
- SEO: https://www.martingaray.com.ar/seo/
- Analytics: https://www.martingaray.com.ar/analytics/
- Tag Manager: https://www.martingaray.com.ar/tagmanager/
- eCommerce: https://www.martingaray.com.ar/ecommerce/
- Docs: https://www.martingaray.com.ar/docs/

## Guias clave (pilares recomendados)
- GEO para LLMs — Guia llms.txt: https://www.martingaray.com.ar/chatgpt/seo-para-llms-guia-llms-txt/
- SEO para IA (AIO/ChatGPT/LLMs): https://www.martingaray.com.ar/seo/seo-para-ia-como-posicionar-tu-marca-en-chatgpt-ai-overviews-y-llms/
- UCP (Agentic Commerce)” Guia tecnica: https://www.martingaray.com.ar/analytics/guia-tecnica-ucp-como-adaptar-tu-e-commerce-al-comercio-con-ia/
- Medir trafico de ChatGPT en GA4: https://www.martingaray.com.ar/google-analytics/como-medir-el-trafico-de-chatgpt-en-ga4/
- SEO JSON-LD para eCommerce: https://www.martingaray.com.ar/seo/seo-json-ld-para-ecommerce-seoagent-ready/
- Optimizar crawl budget: https://www.martingaray.com.ar/seo/optimizar-el-crawl-budget-plan-de-mejora-seo/
- Open Graph (CTR social + previews): https://www.martingaray.com.ar/seo/mejora-los-resultados-en-redes-sociales-con-etiquetas-open-graph/

## Servicios (si la intencion es contratar / trabajar)
- Consultor SEO eCommerce (AR): https://www.martingaray.com.ar/seo-posicionamiento-web/
- Migracion / asesoria GA4: https://www.martingaray.com.ar/migracion-google-analytics-4/
- Consultor Google Analytics + Tag Manager: https://www.martingaray.com.ar/consultor-google-analytics-y-tagmanager/
- Suscripcion mensual SEO + Analytics: https://www.martingaray.com.ar/suscripcion-mensual-seo-analytics/

## Inventario completo (para crawling)
- Sitemap XML: https://www.martingaray.com.ar/sitemap.xml
- Sitemap XML Articulos: https://www.martingaray.com.ar/post-sitemap.xml

## Notas para agentes
- Preferir URLs canonicas con https + www cuando aplique.
- Evitar paginas internas/tecnicas (ej.: /search/, /tags/, parametros ?utm_source=, plantillas).
- Si hay conflicto entre contenidos, usar como fuente de verdad: articulos "guia" + Docs + sitemap.xml.
2. /llms-full.txt
- Propósito principal: Este archivo amplía la información del /llms.txt, incluyendo detalles más completos y enlaces secundarios que pueden ser útiles en contextos más específicos o técnicos.
- Formato: También está en Markdown.
- Contenido:
- Información adicional que no es crítica, pero que puede ser valiosa para usuarios avanzados o modelos que necesitan un contexto más amplio.
- Enlaces detallados, incluyendo notas explicativas y recursos menos prioritarios.
- Esencialmente, todo lo que está en /llms.txt, más contenido extendido.
- Uso: Útil para LLMs que necesitan realizar inferencias más profundas o para usuarios que desean comprender todos los aspectos disponibles del sitio o proyecto.
Ejemplo de un archivo llms.txt
Google Utiliza el archivo LLM.txt
“And since we frequently get asked questions about it, no, Google doesn’t support the LLM’s text file. As we’ve mentioned before, you don’t need to do anything special to be displayed in Google’s AI-powered search features.”
John Mueller (Google Search)
Y dado que recibimos preguntas frecuentes al respecto, no, Google no admite el archivo de texto del LLM. Como ya hemos mencionado, no es necesario hacer nada especial para aparecer en las funciones de búsqueda con inteligencia artificial de Google.John Mueller (Google Search)
¿Google necesita codigos especiales como el LLM.txt para aparecer en las funciones de búsqueda con IA?
No. Google no reconoce ni utiliza ningún “LLM text file” para mostrar contenido en sus funciones de búsqueda potenciadas por IA.
¿Es necesario hacer una optimización técnica adicional o preparar archivos especiales para aparecer en la búsqueda con IA de Google?
Tampoco. Según lo mencionado, no hace falta realizar ninguna acción especial ni añadir formatos adicionales para ser elegible en estas funciones. Google utiliza el contenido existente tal como está indexado.
¿Que mejoramos con llms.txt?
- El Estándar llms.txt: Es un protocolo (propuesto en septiembre de 2024) que permite a los sitios web ofrecer un «mapa del tesoro» semántico diseñado específicamente para la inferencia de máquinas, eliminando el «ruido» estructural del HTML. El archivo complementario llms-full.txt consolida todo el contenido relevante en un solo documento Markdown, optimizando el uso de la ventana de contexto de los modelos mediante técnicas de RAG (Retrieval-Augmented Generation).
- Soberanía del Índice: Los principales laboratorios de IA (Meta, OpenAI) están construyendo sus propios índices de búsqueda (Meta-WebIndexer, OAI-SearchBot) para reducir la dependencia, los costos y la latencia de APIs externas como Bing, lo que generará una divergencia en la calidad de las respuestas basadas en la calidad de estos índices propietarios.
- De SEO a GEO: La implicación estratégica es la transición de la Optimización para Motores de Búsqueda (SEO) a la Optimización para Motores Generativos (GEO), donde el factor de clasificación clave es la eficiencia del token. Los webmasters ahora deben gestionar un panorama fragmentado de rastreadores agresivos y especializados.
- Conclusión: La eficiencia en la provisión de información estructurada (a través de llms.txt) no es solo una mejora técnica, sino un requisito económico fundamental para la viabilidad de los modelos de negocio de IA, marcando el triunfo de la «web paralela» diseñada para la inteligencia artificial.
¿Los buscadores utilizan el llms.txt?
- Google Search (Búsqueda tradicional): John Mueller (Google Search) ha minimizado la relevancia de llms.txt para el SEO tradicional, indicando que el archivo es invisible y no se utiliza para la indexación en Google.com.
- Google Agents (Vanguardia): En contraste, el equipo de Google Cloud y el proyecto de Protocolo Agente-a-Agente (A2A) han adoptado llms.txt como un componente fundamental para la interoperabilidad entre agentes autónomos en el futuro ecosistema de IA.
¿Cuales son las Inteligencias artificiales que utilizarían el LLMS.txt?
Existen pruebas de que las siguientes plataformas están utilizando o promoviendo activamente el estándar. Sin embargo, es importante destacar que su objetivo no es mejorar el posicionamiento, sino simplemente ayudar a los agentes autónomos de estas empresas a comprender mejor un sitio web.
| Plataforma | Comportamiento Confirmado | Matiz de Adopción |
| Anthropic (Claude) | Es el actor más alineado. Utiliza llms.txt y llms-full.txt en su propia documentación. Los desarrolladores confirman que inyectar llms-full.txt mejora drásticamente la precisión de Claude en respuestas técnicas. | Promotor Pragmático. Su búsqueda web opera a través de Brave Search, un índice independiente. |
| OpenAI (GPTBot, OAI-SearchBot) | A pesar del hermetismo, el análisis de logs de servidores muestra que GPTBot y OAI-SearchBot acceden rutinariamente a archivos llms.txt (con patrones repetitivos), sugiriendo que se utilizan como señales de alta calidad para contenido estructurado. | Adopción Silenciosa. Utiliza un modelo híbrido con Bing y su propio OAI-SearchBot. |
| Perplexity AI | Estructura su propia documentación con el estándar. Su arquitectura de búsqueda propietaria se centra en la indexación de «unidades sub-documento,» lo que se alinea perfectamente con la estructura categorizada de llms.txt para mejorar la «conexión a tierra» (grounding). | Consumidor y Productor. Es uno de los principales ejemplos de soberanía del índice. |
| Apple (Applebot-Extended) | Introdujo Applebot-Extended que permite a los webmasters control granular para que su contenido se use en Siri/Spotlight (Applebot) pero no para entrenar los modelos fundacionales de Apple (Applebot-Extended), reflejando la tendencia a diferenciar el uso de datos. | Enfoque de Control Granular. |
La adopción del estándar llms.txt es asimétrica:
- oficialmente, Google Search no lo tiene en cuenta para el SEO tradicional, pero el equipo de Google Agents sí lo ha adoptado para la interoperabilidad futura (Protocolo A2A).
- Anthropic (Claude) es el principal promotor pragmático, utilizándolo y confirmando que llms-full.txt mejora drásticamente la precisión en respuestas técnicas.
- OpenAI, aunque no lo confirma de manera oficial, su uso está validado por el análisis de logs de servidores (evidencia forense) que revela un acceso rutinario de sus crawlers como señal de alta calidad
- Perplexity lo usa en su propia documentación y Apple ha introducido Applebot-Extended, una medida oficial que refleja el espíritu de control granular de datos del estándar.
Próximos pasos en SEO para LLMs
La adopción de llms.txt aún está en sus primeras etapas, pero ya está siendo respaldada por plataformas como Anthropic, Hugging Face y Zapier. Si querés sumarte, podés empezar implementando el archivo en tu sitio y ajustándolo según las necesidades de tu audiencia.
El llms.txt representa una oportunidad para optimizar la interacción entre los sitios web y los modelos de lenguaje, beneficiando tanto a desarrolladores como a usuarios finales. Su adopción promete una web más eficiente y organizada, tanto para humanos como para la inteligencia artificial.
Yo lo implemente fundamentalmente como TEST, para evaluar proyectos con y sin llms.txt, el tiempo (y las documentaciones oficiales) nos dirán ¿cuales son las mejores practicas, Por ahora no hay evidencia alguna de qué implementarlo mejora algún tipo de visibilidad en agentes